 AHALab · 科學與我們
天氣模型做出來之後,
還需要哪些證據?
Atria團隊展示了AI參與天氣模型研發的案例。一個能執行的演示,讓我們看見了工作成果;它能在哪些地方、哪些天氣下可靠地使用,還需要另外檢驗。
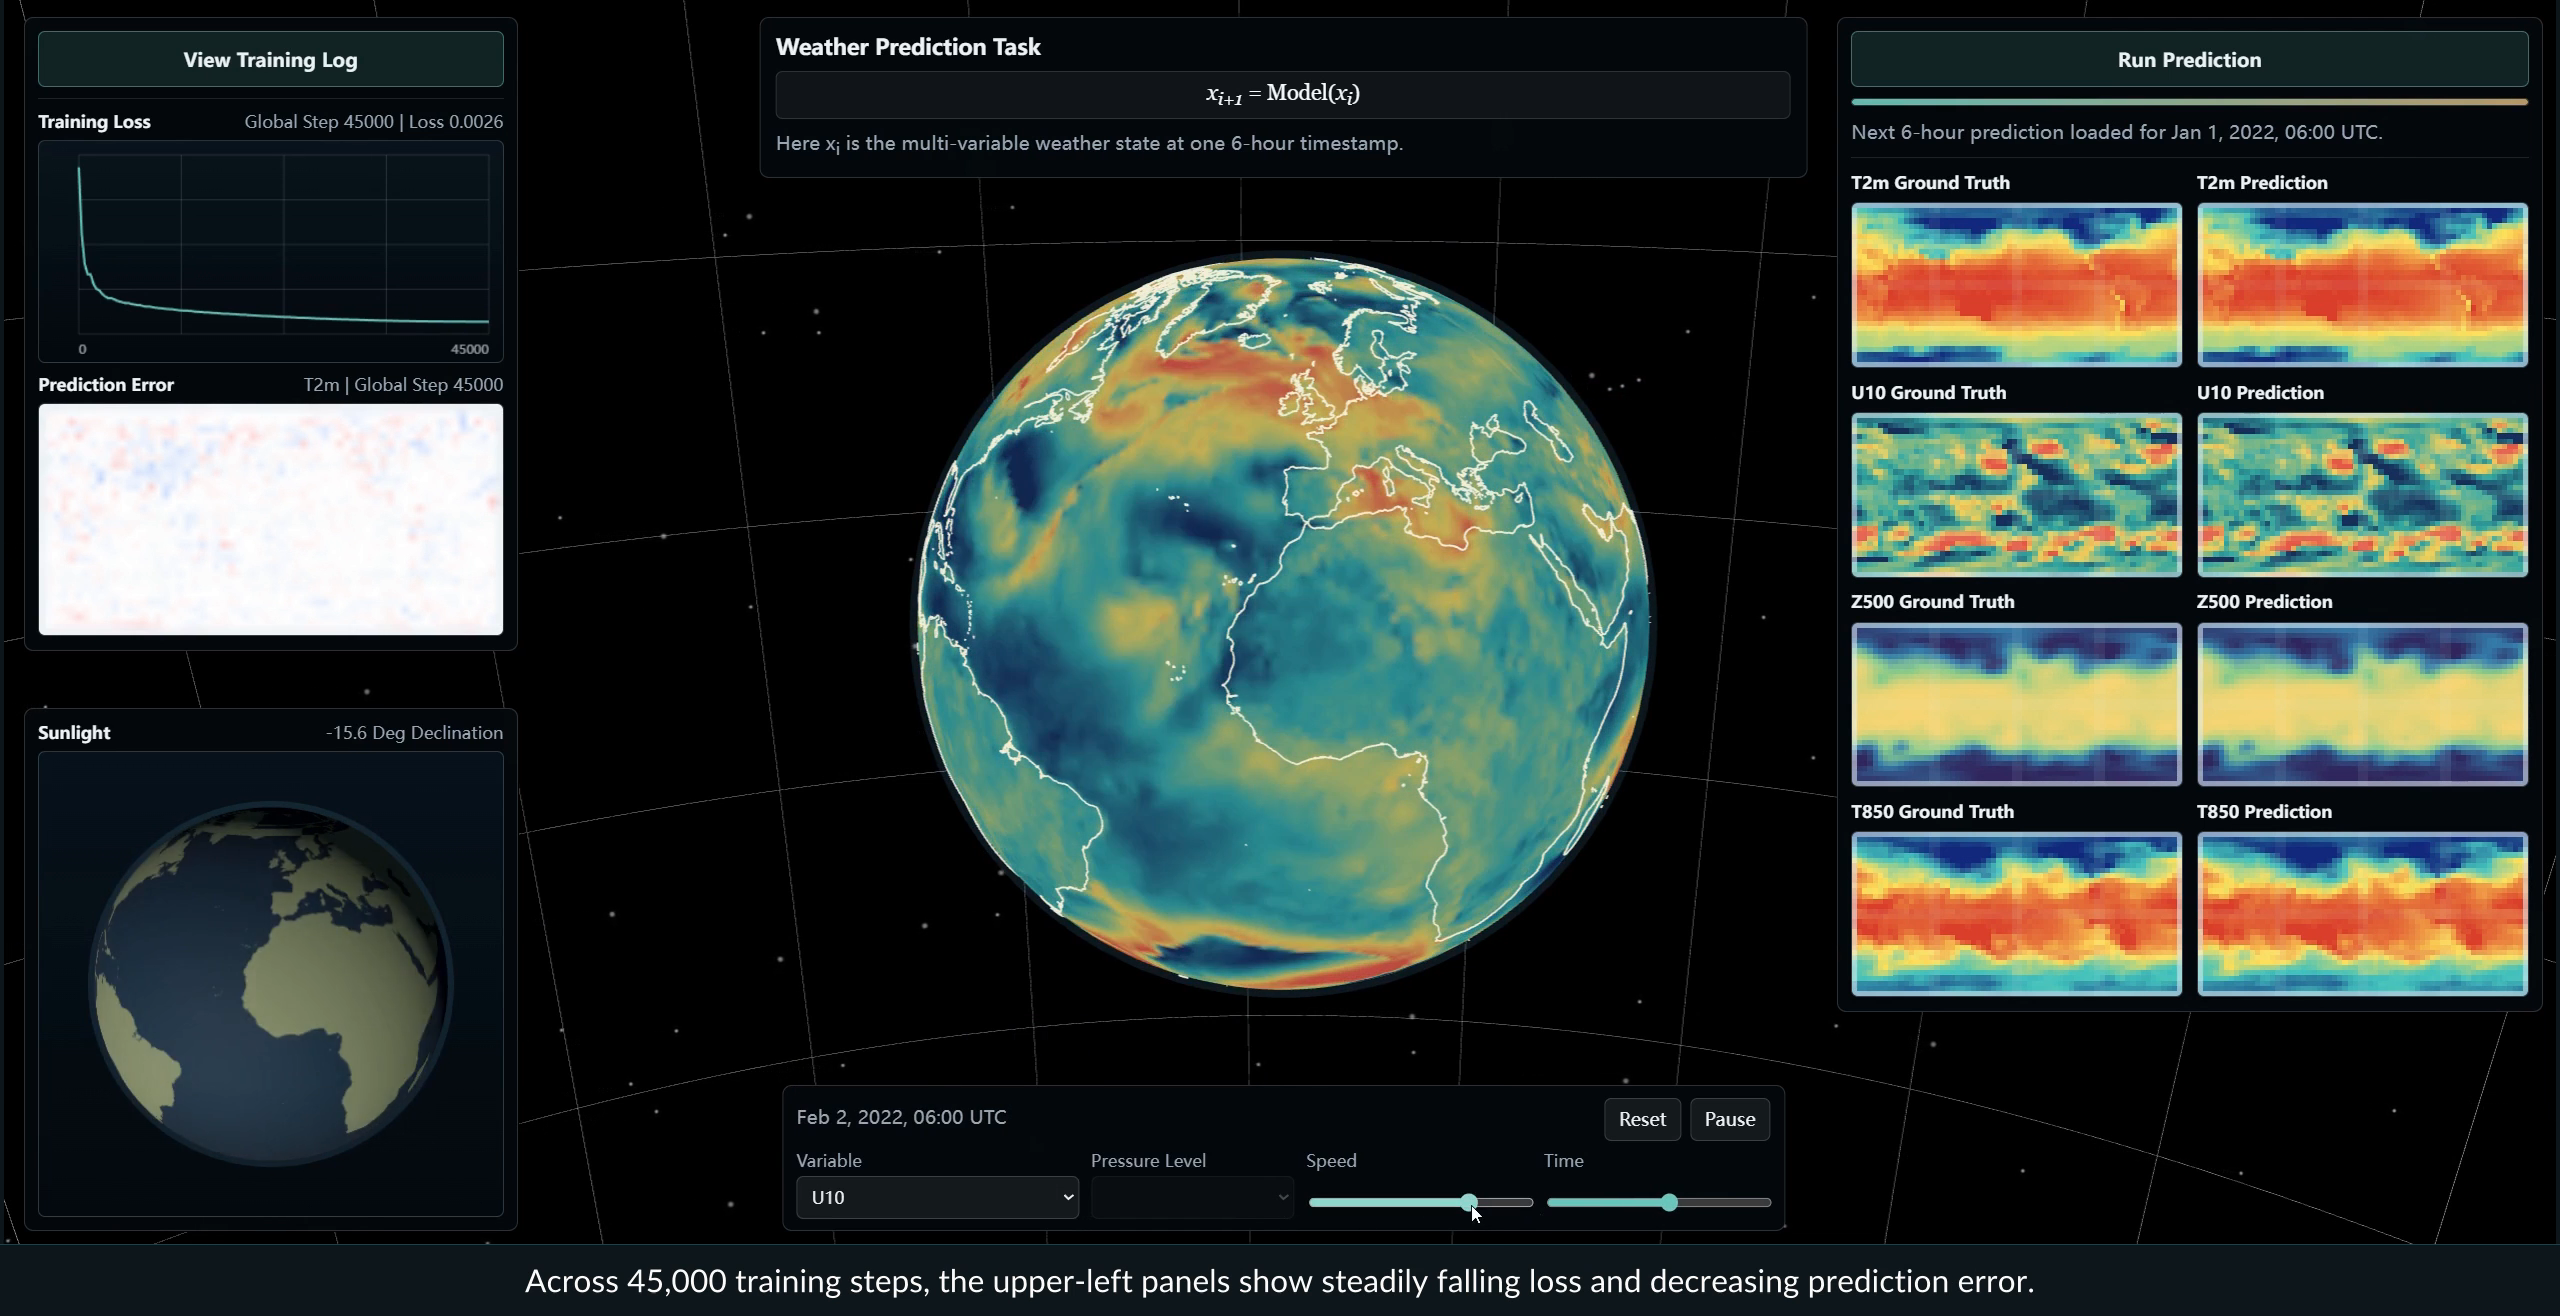
這份報告記錄了什麼?
作者介紹,在停用網路搜尋的案例中,AI處理了100GB以上的氣象資料,實現4億以上引數的網路,運行了45,000步訓練,涉及69個氣象變數。
這些是作者提供的案例記錄。本課程沒有獨立復現其訓練,也沒有用這套模型釋出即時預報。
依據:報告第4—5頁。作者註明這些是精選演示,不能作為平均任務成功率。
怎樣繼續檢驗?
- 查清資料是誰製作的,覆蓋什麼時間、地方和變數。
- 最終測試使用未參與訓練和調參的資料,防止答案提前洩漏。
- 在相同任務和條件下,與合適的參照和基線比較;分別檢查預報時效、區域、變數和極端事件。
- 確認使用者需要什麼。全球天氣預測、山路出行和洪水預警,需要的資料與檢驗並不相同。
這是課堂提出的檢驗要求,不表示已經對該演示完成這些檢查。參照資料本身也有誤差和適用範圍。
如果天氣圖已經生成,你會先查哪一項,再決定要不要使用?
人和AI怎樣一起工作?
團隊還分析了56位參與者的769條任務記錄。在這批記錄裡,AI會提出方案、執行和修改;人參與選擇目標與方法、補充背景和判斷結果。
這些資料可以幫助我們理解具體協作過程。它們來自這一個研發團隊,不能證明所有科研任務都採用相同分工,也不能證明人的判斷一定正確。
依據:報告第8、10—11頁;不同百分比的任務範圍和分母不同,不能混算。
暫時不能從這裡推出什麼?
“一分鐘預測未來一週”不能解釋成一分鐘完成整個模型研發。本次查到的報告相應段落沒有提供足以核驗該耗時配置或與FourCastNet比較的詳細結果。
AI能參與研發另一套AI,也不等於已經證明它能持續、可靠地自主改進自己。報告仍把這件事列為開放問題。
依據:報告第7—8、12—13頁。課堂不採用宣傳標題或排行榜作為實用性證據。
出處與閱讀記錄
依據2026年9月15日取得的23頁報告快照。GitHub main可能繼續更新;影像未經重繪,作者與原始出處保留。課堂討論由AHALab整理。