 AHALab · 과학과 우리
날씨 모델이 완성된 후,
어떤 증거가 더 필요한가?
Atria 팀은 AI가 날씨 모델 연구 개발에 참여한 사례를 보여주었음. 실행 가능한 데모를 통해 작업 결과를 볼 수 있었음; 어떤 장소, 어떤 날씨에서 신뢰성 있게 사용할 수 있는지는 별도로 검증 필요.
이 보고서는 무엇을 기록했는가?
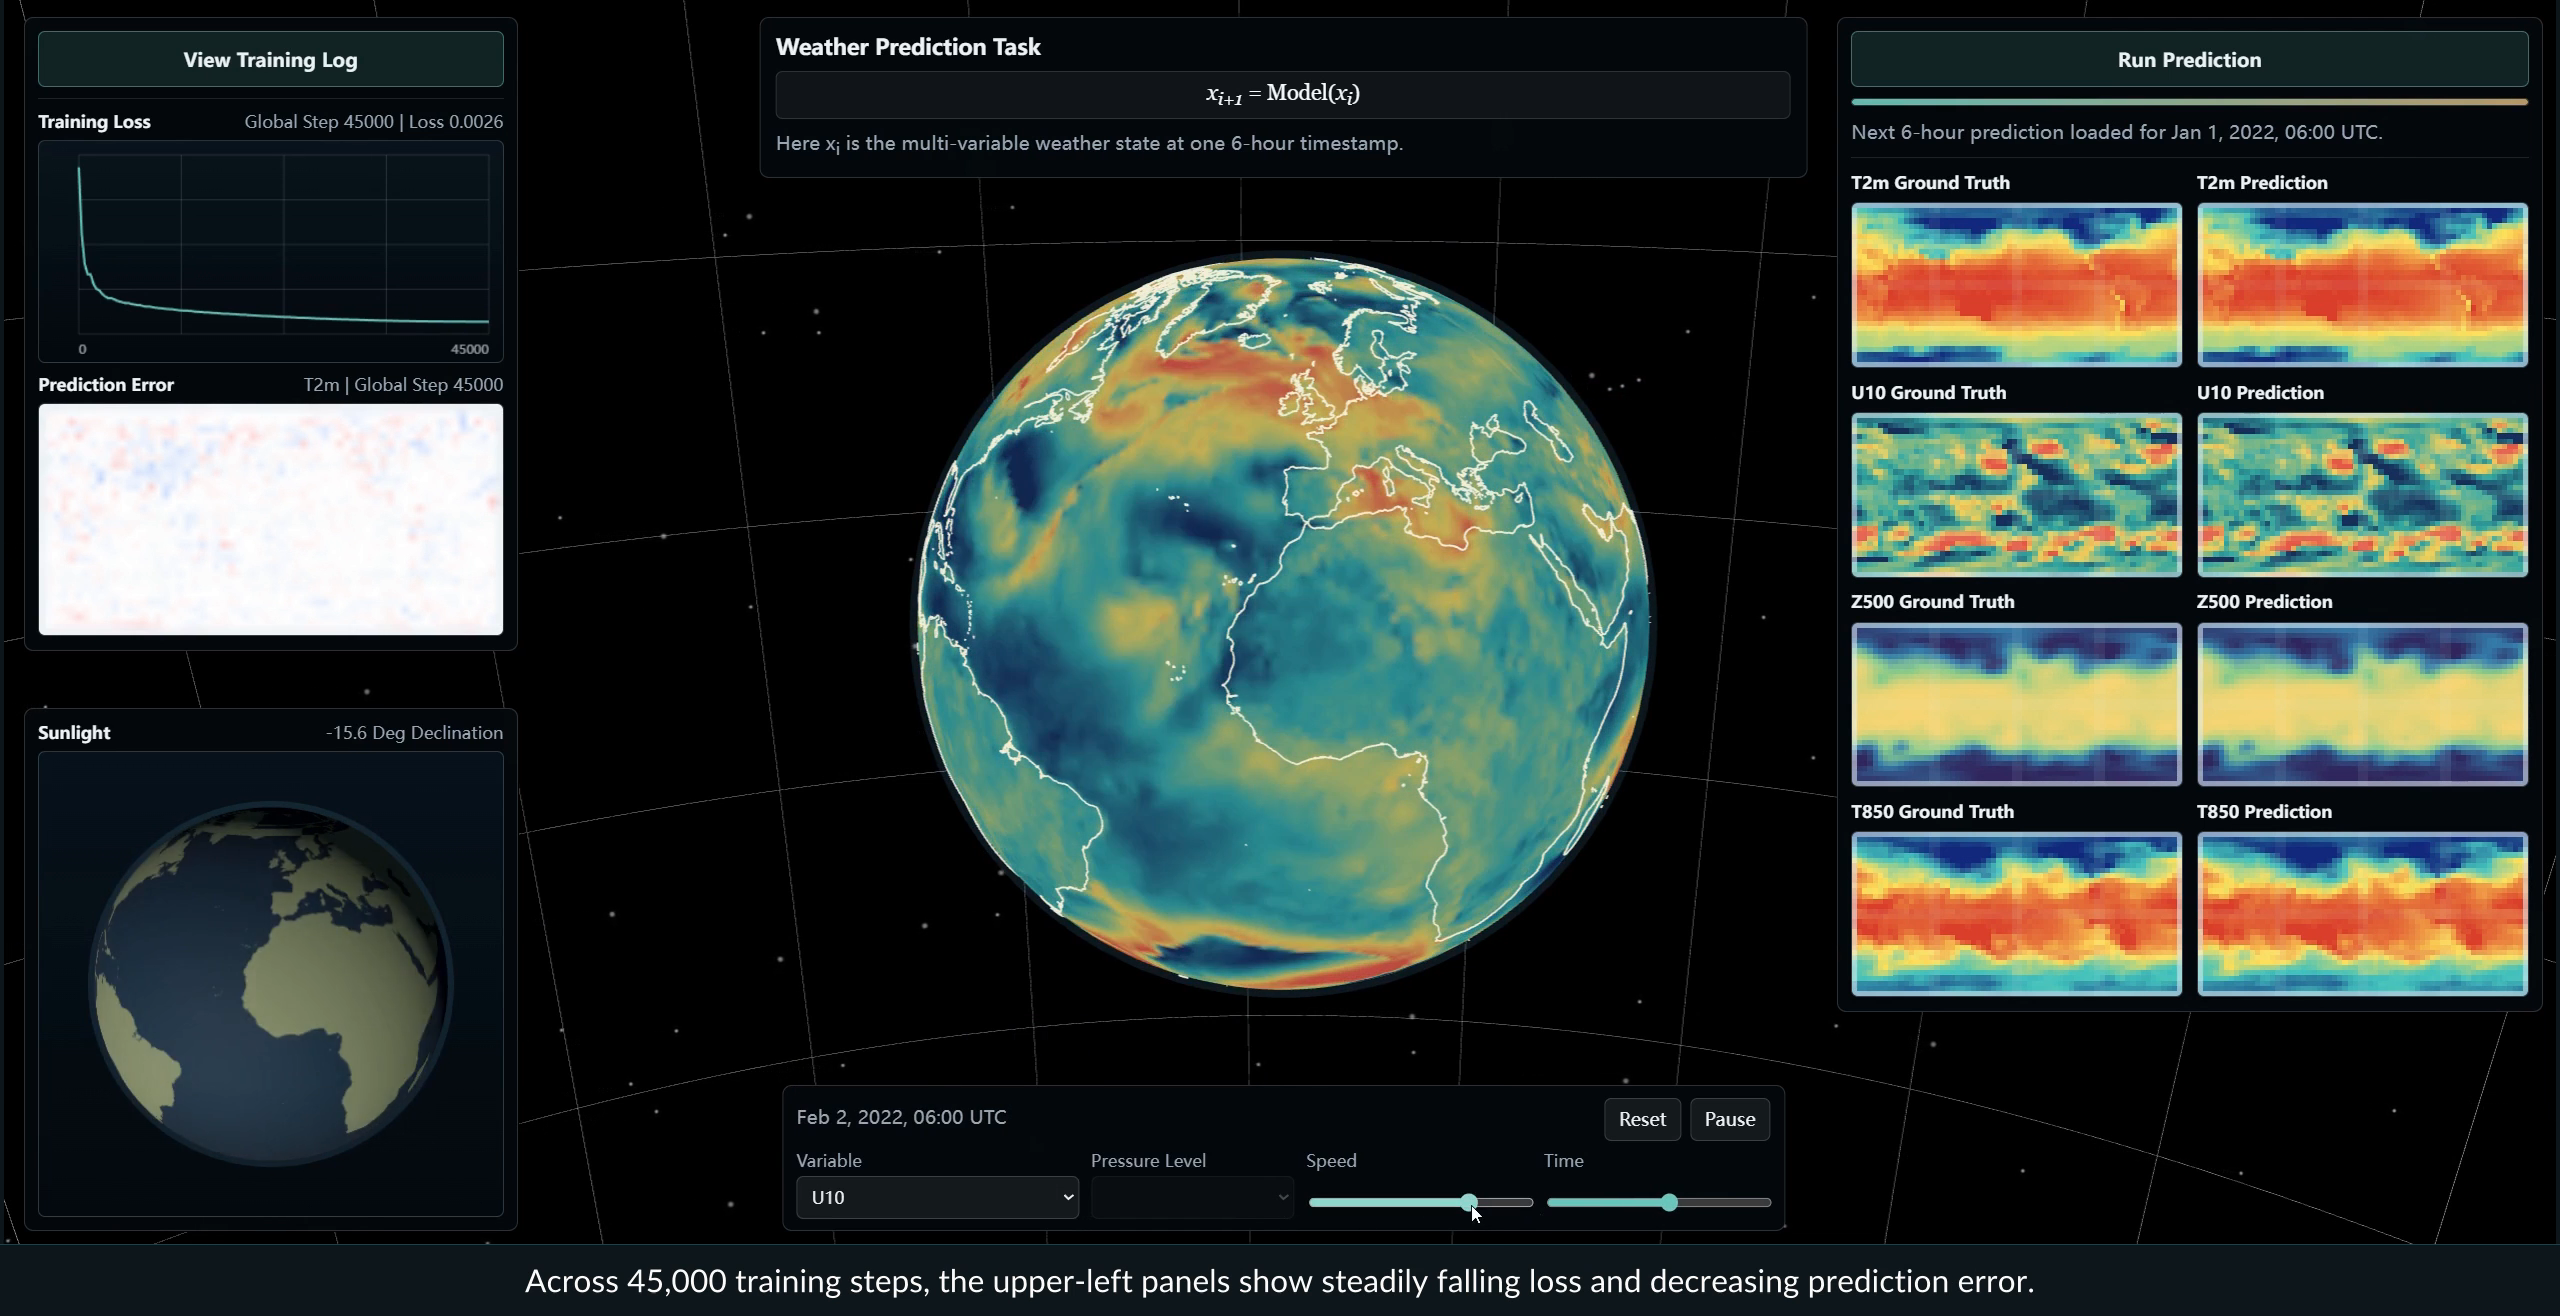
저자 소개, 네트워크 검색이 금지된 사례에서 AI는 100GB 이상의 기상 데이터를 처리하고 4억 개 이상의 매개변수 네트워크를 구현했으며, 45,000스텝의 훈련을 수행했고, 69개의 기상 변수가 포함되었습니다.
이것들은 저자가 제공한 사례 기록입니다. 본 과정에서는 독립적으로 훈련을 재현하지 않았으며, 이 모델을 사용해 실시간 예보를 공개하지 않았습니다.
근거: 보고서 4-5페이지. 저자는 이것들이 선택된 시연 사례라고 명시했으며, 평균 작업 성공률로 삼을 수 없습니다.
어떻게 검증을 계속할까요?
- 데이터를 만든 사람, 시간, 장소, 변수를 확인합니다.
- 최종 테스트에서는 훈련 및 매개변수 조정에 참여하지 않은 데이터를 사용하여 답이 미리 누설되는 것을 방지합니다.
- 동일한 작업과 조건 하에서 적절한 참조 및 기준과 비교하고, 예보 시효, 지역, 변수, 극단적 사건을 각각 확인합니다.
- 사용자가 무엇을 필요로 하는지 확인합니다. 글로벌 날씨 예보, 산길 이동, 홍수 경보 등 필요한 자료와 검증 방식이 다릅니다.
이것은 수업에서 제시한 검증 요구사항으로, 해당 시연이 이미 이러한 검사를 완료했다는 것을 의미하지 않습니다. 참조 데이터 자체에도 오차와 적용 범위가 있습니다.
사람과 AI는 어떻게 함께 일할까요?
팀은 또한 56명의 참가자와 769개의 작업 기록을 분석했습니다. 이 기록들에서 AI는 계획을 제안하고 실행하며 수정하며, 사람은 목표 및 방법 선택, 배경 보충, 결과 판단에 참여합니다.
이러한 자료는 구체적인 협력 과정을 이해하는 데 도움이 될 수 있습니다. 이들은 단일 연구개발 팀에 속한 자료로, 모든 과학 연구 과제가 동일한 분업을 사용한다고 증명할 수 없으며, 사람의 판단이 반드시 올바르다는 것을 증명할 수 없습니다.
근거: 보고서 8, 10-11페이지; 서로 다른 백분율의 작업 범위와 분모가 다르므로 혼합 계산할 수 없습니다.
여기서 당장 무언가를 결론지을 수 있을까?
"1분으로 한 주를 예측"을 모델 개발 전체를 1분 만에 완료했다고 해석할 수는 없다. 이번에 확인한 보고서 해당 부분에는 이 소요 시간 설정을 검증하거나 FourCastNet과 비교할 수 있는 충분한 상세 결과가 제공되지 않았다.
AI가 또 다른 AI를 개발에 참여할 수 있다고 해서, 그것이 지속적이고 신뢰할 수 있게 스스로를 개선할 수 있다는 것을 입증한 것은 아니다. 보고서는 여전히 이 사안을 미해결 문제로 분류하고 있다.
근거: 보고서 7–8, 12–13페이지. 수업에서는 홍보용 제목이나 순위표를 실용성 증거로 사용하지 않는다.
출처 및 읽기 기록
로컬 보고서 · 5페이지 ↗공식 보고서 ↗공식 프로젝트 ↗
2026년 9월 15일 확보한 23페이지 보고서 스냅샷 기준. GitHub main은 계속 업데이트될 수 있음; 이미지는 재작성되지 않았으며, 저자와 원출처는 유지. 수업 토론은 AHALab에서 정리함.