 AHALab · 科学与我们
天气模型做出来之后,
还需要哪些证据?
Atria团队展示了AI参与天气模型研发的案例。一个能运行的演示,让我们看见了工作成果;它能在哪些地方、哪些天气下可靠地使用,还需要另外检验。
这份报告记录了什么?
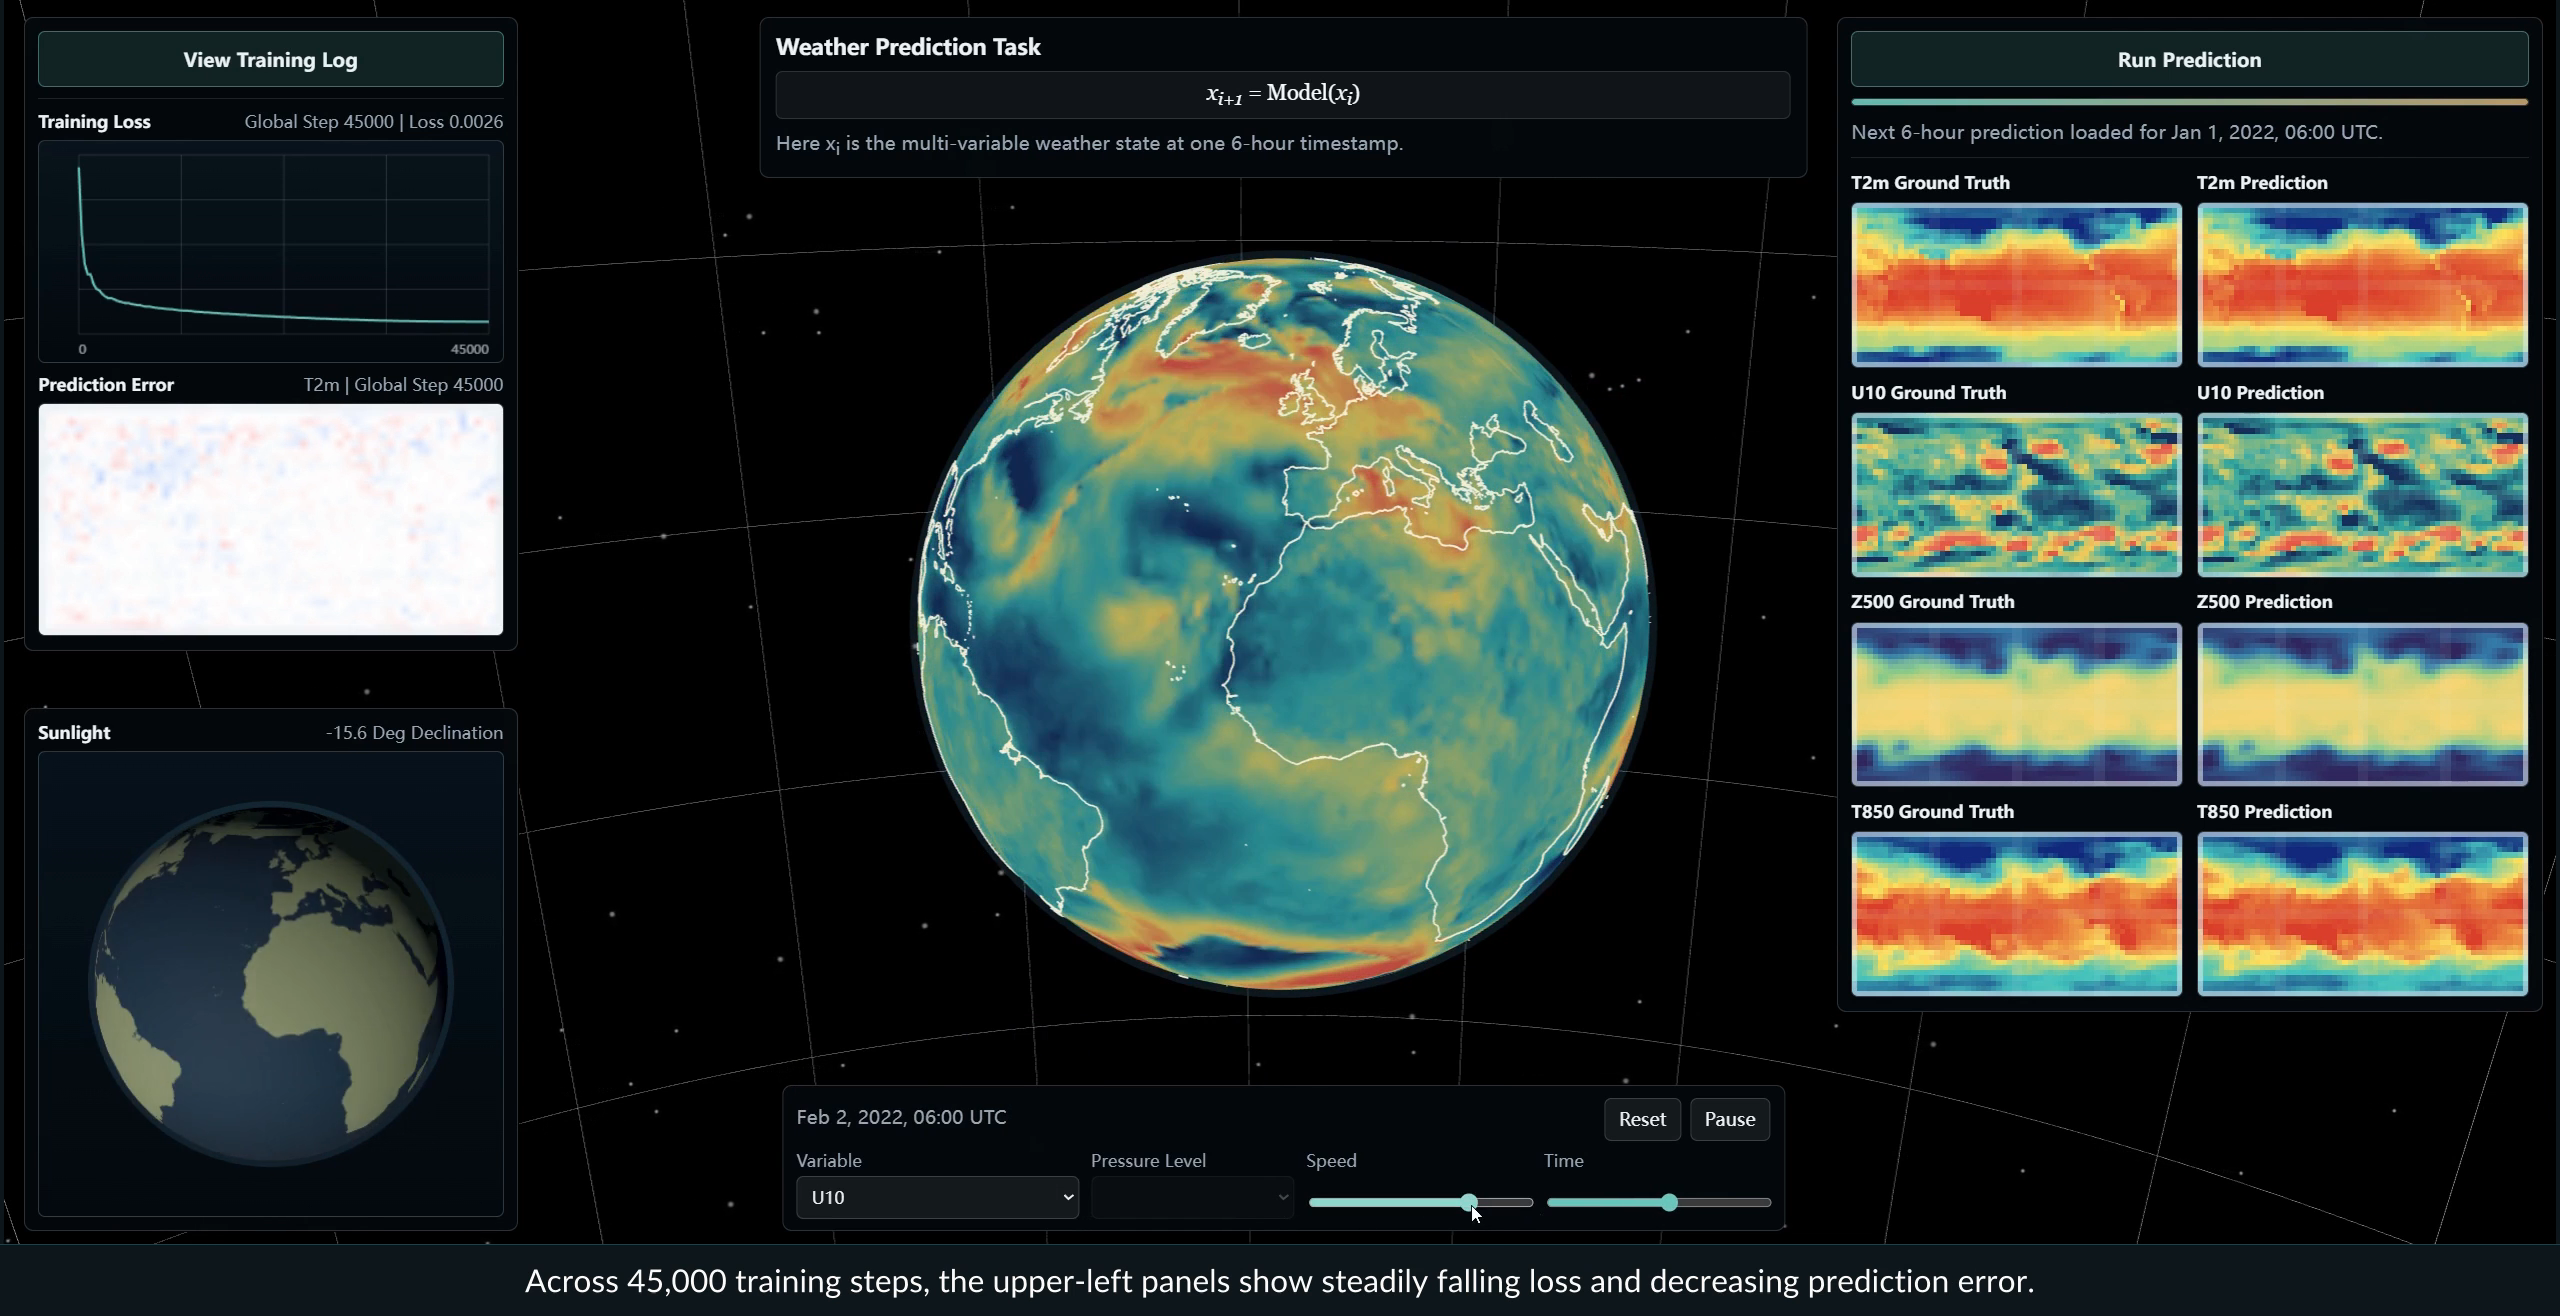
作者介绍,在禁用网络搜索的案例中,AI处理了100GB以上的气象数据,实现4亿以上参数的网络,运行了45,000步训练,涉及69个气象变量。
这些是作者提供的案例记录。本课程没有独立复现其训练,也没有用这套模型发布实时预报。
依据:报告第4—5页。作者注明这些是精选演示,不能作为平均任务成功率。
怎样继续检验?
- 查清数据是谁制作的,覆盖什么时间、地方和变量。
- 最终测试使用未参与训练和调参的数据,防止答案提前泄漏。
- 在相同任务和条件下,与合适的参照和基线比较;分别检查预报时效、区域、变量和极端事件。
- 确认使用者需要什么。全球天气预测、山路出行和洪水预警,需要的资料与检验并不相同。
这是课堂提出的检验要求,不表示已经对该演示完成这些检查。参照数据本身也有误差和适用范围。
如果天气图已经生成,你会先查哪一项,再决定要不要使用?
人和AI怎样一起工作?
团队还分析了56位参与者的769条任务记录。在这批记录里,AI会提出方案、执行和修改;人参与选择目标与方法、补充背景和判断结果。
这些资料可以帮助我们理解具体协作过程。它们来自这一个研发团队,不能证明所有科研任务都采用相同分工,也不能证明人的判断一定正确。
依据:报告第8、10—11页;不同百分比的任务范围和分母不同,不能混算。
暂时不能从这里推出什么?
“一分钟预测未来一周”不能解释成一分钟完成整个模型研发。本次查到的报告相应段落没有提供足以核验该耗时配置或与FourCastNet比较的详细结果。
AI能参与研发另一套AI,也不等于已经证明它能持续、可靠地自主改进自己。报告仍把这件事列为开放问题。
依据:报告第7—8、12—13页。课堂不采用宣传标题或排行榜作为实用性证据。
出处与阅读记录
依据2026年9月15日取得的23页报告快照。GitHub main可能继续更新;图像未经重绘,作者与原始出处保留。课堂讨论由AHALab整理。